
Untuk membandingkan dua peramal, gunakan kejadian dan aturan hitung yang sama. Brier score dan log loss sama-sama menilai prakiraan probabilitas, tetapi memberi penalti yang berbeda. Perbedaan paling jelas muncul ketika hasil yang diberi peluang sangat kecil justru terjadi.
Nilai Brier yang lebih kecil daripada nilai log loss bukan berarti hasilnya lebih baik: keduanya memakai skala berbeda. Brier biner memberi penalti kuadrat yang terbatas. Log loss lebih peka terhadap kesalahan yang sangat yakin dan tidak memiliki batas atas.
Anda boleh melaporkan keduanya. Tetapkan metrik utama sebelum melihat hasil, lalu nyatakan skala Brier, basis logaritma, cara agregasi, dan clipping. Dalam tulisan ini, loss berarti nilai penalti statistik, bukan kerugian uang.
Kenali aturan sebelum membandingkan angka
| Pertanyaan | Brier score | Log loss |
|---|---|---|
| Apa yang dihitung? | Kuadrat selisih probabilitas dan hasil | Negatif logaritma probabilitas kelas yang benar-benar terjadi |
| Nilai untuk prediksi sempurna? | 0 | 0 sebelum clipping |
| Rentangnya? | 0–1 untuk konvensi biner di sini; 0–2 untuk jumlah seluruh kelas | 0 sampai positif tak hingga untuk hasil diskret |
| Bagaimana salah yang sangat yakin diperlakukan? | Mendekati maksimum yang terbatas | Meningkat tanpa batas atas |
| Konvensi apa yang harus disebutkan? | Biner atau jumlah seluruh kelas | Basis logaritma dan perlakuan titik ujung |
Dalam konvensi loss, lebih kecil berarti lebih baik. Jika suatu sumber menyajikan logarithmic score dengan tanda sebaliknya, arah penilaiannya juga berbalik. Jangan menyamakan label tanpa memeriksa rumusnya. Teori scoring rule
Mulai dari probabilitas, bukan hanya pilihan ya atau tidak
Untuk kejadian biner yang sudah didefinisikan, tulis:
- p = probabilitas “ya”, dengan 0 ≤ p ≤ 1.
- y = 1 jika “ya” terjadi, atau 0 jika tidak.
- Probabilitas “tidak” = 1 − p.
Prediksi 51% dan 99% sama-sama memilih “ya”, tetapi tingkat keyakinannya berbeda. Jika hasilnya “ya”, Brier binernya masing-masing 0.2401 dan 0.0001. Hitungan benar atau salah saja tidak menangkap perbedaan ini.
Untuk satu prediksi:
Brier biner = (p − y)²
Log loss dengan ln = −ln(p) jika y = 1, atau −ln(1 − p) jika y = 0.
Untuk 0 < p < 1, rumus kedua juga dapat ditulis −[y ln(p) + (1 − y) ln(1 − p)]. Bentuk bercabang memudahkan pembahasan p = 0 dan p = 1. Pada N prediksi berbobot sama dengan N > 0, jumlahkan loss tiap prediksi lalu bagi dengan N.
Rumus dan tabel menggunakan titik sebagai tanda desimal: 0.80 berarti 80%. Definisi Brier, definisi log loss
Tiga prediksi yang sama, dinilai dengan dua cara
Semua data berikut fiktif. Probabilitas dicatat sebelum hasilnya diketahui. Ketiga kejadian memiliki definisi ya/tidak yang tetap dan hasil yang sudah dipastikan. Bobotnya sama, dan perhitungan utama tidak menggunakan clipping. Ini bukan rekam jejak suatu platform.
| Kejadian | p(ya) | Hasil y | Brier biner | Log loss dengan ln |
|---|---|---|---|---|
| A | 0.80 | 1 | 0.040000 | 0.223144 |
| B | 0.30 | 0 | 0.090000 | 0.356675 |
| C | 0.01 | 1 | 0.980100 | 4.605170 |
| Rata-rata | 0.370033 | 1.728330 |
Pada B, hasilnya “tidak”, sehingga log loss menggunakan −ln(0.70), bukan −ln(0.30). Pada C, hasil yang terjadi hanya diberi peluang 1%, sehingga penalti kedua aturan besar.
Rata-rata Brier adalah (0.04 + 0.09 + 0.9801) ÷ 3 = 0.370033. Rata-rata log loss adalah [−ln(0.80) − ln(0.70) − ln(0.01)] ÷ 3 = 1.728330.
Semua rata-rata dihitung dari nilai yang belum dibulatkan, lalu ditampilkan sampai enam angka di belakang desimal. Bandingkan Brier seorang peramal dengan Brier peramal lain pada kejadian dan konvensi yang sama. Membandingkan 0.370033 langsung dengan 1.728330 mencampurkan dua skala.
Mengapa satu kesalahan sangat yakin bisa berpengaruh besar?
Jika hasilnya ditetapkan “ya”, kenaikan p menurunkan kedua loss. Namun, saat p mendekati nol, Brier mendekati 1, sedangkan log loss terus meningkat.
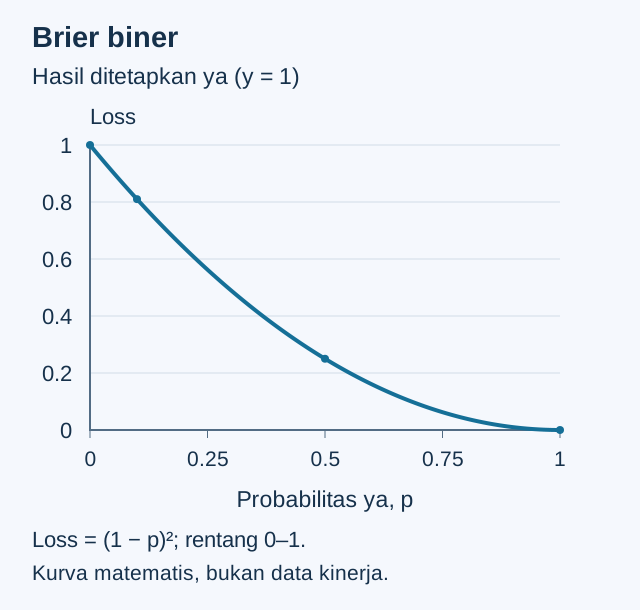
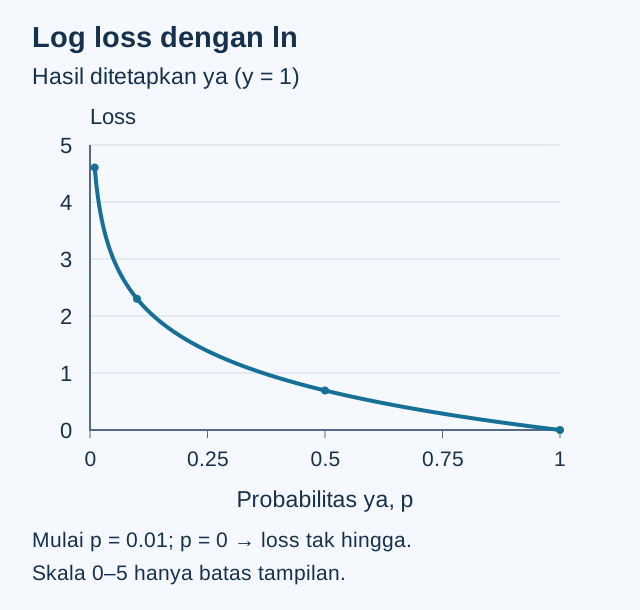
| p(ya), ketika ya terjadi | Brier biner | Log loss dengan ln |
|---|---|---|
| 0.50 | 0.250000 | 0.693147 |
| 0.10 | 0.810000 | 2.302585 |
| 0.01 | 0.980100 | 4.605170 |
| 0.00 | 1.000000 | Positif tak hingga, tanpa clipping |
Brier tetap menghukum kesalahan yang sangat yakin; kontribusi setiap kejadian hanya dibatasi. Log loss tidak memiliki plafon seperti itu. Sedikit kesalahan yang sangat yakin dapat memberi pengaruh besar pada rata-rata.
Periksa apakah Brier menjumlahkan semua kelas
Rumus biner di atas menghitung probabilitas “ya”. Konvensi lain menjumlahkan kuadrat kesalahan seluruh kelas. Untuk dua kelas:
Brier jumlah kelas = (p − y)² + [(1 − p) − (1 − y)]² = 2(p − y)².
Karena itu, rata-rata tiga contoh menjadi 0.740067 dengan jumlah seluruh kelas, dibanding 0.370033 dengan konvensi biner. Prediksinya tidak berubah. Perkalian positif yang sama pada seluruh skor juga tidak mengubah peringkat.
Hitung dua kali rata-rata sebelum pembulatan. Mengalikan nilai tampilan yang sudah dibulatkan dapat menghasilkan digit terakhir yang berbeda.
Untuk kelas yang saling eksklusif dan mencakup semua kemungkinan, rentang Brier jumlah kelas adalah 0–2. Pembagian dengan dua menghasilkan skala 0–1. Nama “Brier score” saja tidak memastikan konvensi yang dipakai. Dokumentasi skala Brier
Contoh satu kejadian dengan tiga hasil
Misalkan satu kejadian fiktif hanya mempunyai hasil A, B, atau C. Probabilitasnya 0.70, 0.20, 0.10, berjumlah 1. Jika A terjadi, vektor hasilnya (1, 0, 0).
| Hasil | Probabilitas | Indikator hasil | Kuadrat selisih |
|---|---|---|---|
| A | 0.70 | 1 | 0.09 |
| B | 0.20 | 0 | 0.04 |
| C | 0.10 | 0 | 0.01 |
Brier jumlah kelas adalah 0.09 + 0.04 + 0.01 = 0.14. Jika secara eksplisit memakai skala setengah, nilainya 0.07. Jangan membagi lagi dengan tiga kelas dan menyebutnya konvensi yang sama.
Log loss kategorikal hanya memakai probabilitas hasil yang terjadi: −ln(0.70) = 0.356675. Jangan menambahkan −ln(1 − p) untuk setiap kelas yang kalah.
Contoh ini mempunyai satu kelas yang terjadi. Sekumpulan label yang dapat terjadi bersamaan membutuhkan pengaturan lain; rumus kategorikal tersebut tidak boleh dipindahkan secara otomatis. Definisi kategorikal
Basis logaritma dan titik ujung mengubah angka yang dilaporkan
Basis yang berbeda bukan kinerja yang berbeda
ln berarti logaritma natural, berbasis e. Untuk memakai basis 2, bagi natural-log loss dengan ln(2). Rata-rata tiga contoh menjadi 2.493452, bukan 1.728330.
Perubahan basis yang seragam ini hanya mengalikan skor dengan konstanta positif, sehingga peringkat tetap. Saat membandingkan alat atau publikasi, periksa juga apakah yang ditampilkan rata-rata atau jumlah dan apakah ada bobot sampel.
Probabilitas nol berbeda dari operasi numerik yang gagal
Tanpa clipping, probabilitas 1 pada hasil yang benar memberi log loss 0. Probabilitas 0 pada hasil yang benar memberi log loss positif tak hingga. Untuk Brier biner, kedua kasus itu masing-masing bernilai 0 dan 1.
Dalam rumus yang diperluas, gunakan konvensi limit yang sesuai untuk 0 × ln(0), atau hitung langsung dari probabilitas kelas yang terjadi. Operasi numerik yang menghasilkan nilai tidak terdefinisi bukan berarti titik ujung matematisnya tidak ada.
Clipping adalah pilihan perhitungan yang perlu dicatat
Sebagai contoh pendidikan, tetapkan ε = 0.000001, lalu ganti p dengan:
min(1 − ε, max(ε, p)).
Jika semula p = 0 dan hasilnya “ya”, log loss setelah clipping menjadi −ln(0.000001) = 13.815511, bukan tak hingga.
Nilai ε tersebut bukan klaim tentang default suatu pustaka. Dokumentasi scikit-learn yang diperiksa menjelaskan clipping berdasarkan presisi mesin dari tipe data probabilitas. Perilaku implementasi harus dicek terhadap versi yang benar-benar dijalankan.
Clipping mengubah skor yang dievaluasi. Beberapa probabilitas yang melewati batas sama akan dipetakan ke nilai sama dan tak lagi dapat dibedakan oleh perhitungan itu. Simpan probabilitas asli, ambang clipping, dan jumlah kasus yang terkena clipping. Log loss dan perlakuan numerik
“Strictly proper” adalah pernyataan tentang ekspektasi
Dalam definisi matematisnya, Brier dan log loss adalah strictly proper scoring rules: distribusi probabilitas yang benar secara unik meminimalkan expected loss. Ini mendorong pelaporan probabilitas yang sungguh diyakini, bukan perubahan angka untuk memperbaiki skor harapan. Bukan jaminan mendapat skor terbaik pada setiap sampel kecil.
Untuk kejadian biner dengan probabilitas sebenarnya q:
Expected Brier = q(1 − p)² + (1 − q)p² = q(1 − q) + (p − q)².
Jika q = 0.70, menyatakan p = 0.70 memberi expected loss 0.21, sedangkan p = 0.90 memberi 0.25. Tetapi jika satu hasil berikutnya kebetulan “ya”, prediksi 90% memperoleh loss lebih kecil pada kejadian itu. Hasil harapan dan hasil yang teramati menjawab pertanyaan berbeda.
Strict propriety aturan aslinya juga tidak berarti implementasi clipping dapat memberi penghargaan unik kepada semua probabilitas asli yang sudah dipetakan ke satu nilai. Teori propriety
Enam langkah untuk membandingkan peramal secara adil
- Samakan kejadian dan aturan hasil. Nyatakan pertanyaan, batas waktu, label kelas, dan sumber penentuan hasil. “Menang dalam waktu normal” berbeda dari “lolos setelah perpanjangan waktu”. Tentukan sejak awal perlakuan kejadian batal, disengketakan, atau yang hasilnya belum ditetapkan.
- Samakan waktu prediksi. Bandingkan informasi dan waktu tersisa yang sepadan. Jangan menyamakan prediksi awal suatu sumber dengan pembaruan sumber lain yang mendekati hasil tanpa menjelaskan perbedaannya.
- Samakan kumpulan evaluasi. Gunakan kejadian yang hasilnya sudah ditetapkan pada kumpulan evaluasi yang sama, laporkan jumlahnya dan prediksi yang hilang. Memilih kejadian mudah atau sulit yang berbeda dapat menyesatkan perbandingan agregat.
- Nyatakan aritmetikanya. Sebut skala Brier, basis log, rata-rata atau jumlah, bobot, clipping, dan urutan kelas. Rata-rata berbobot adalah Σ(wᵢ × lossᵢ) ÷ Σwᵢ, dengan wᵢ ≥ 0 dan total bobot positif. Jelaskan arti bobot tersebut.
- Pisahkan evaluasi dari fitting dan tuning. Nilai kinerja pada hasil yang tidak digunakan untuk menyesuaikan metode. Jika prakiraan diperbarui berulang kali, tentukan satu snapshot tetap per kejadian atau beberapa snapshot beserta bobotnya.
- Pakai baseline yang ditetapkan sebelumnya. Jelaskan cara membuatnya. Prediksi selalu 50% memberi Brier biner 0.25 dan natural-log loss 0.693147 untuk setiap kejadian biner, tetapi belum tentu menjadi acuan yang informatif pada kumpulan kejadian yang tidak seimbang.
Daftar ini adalah protokol evaluasi, bukan ambang universal untuk menyatakan skor “bagus”. Keunggulan kecil pada sampel tertentu tidak otomatis membuktikan keunggulan yang bertahan.
Apa yang belum dijelaskan oleh kedua skor?
Kalibrasi. Dalam kumpulan kasus yang memadai, sekitar 70% dari kejadian yang diprediksi mendekati 70% semestinya terjadi. Brier yang lebih rendah saja tidak membuktikan kalibrasi lebih baik: daya pembeda hasil dan ketidakpastian data juga memengaruhi skor. Gunakan kurva kalibrasi atau reliability diagram dengan jumlah pengamatan yang cukup dan jumlah kasus per bin yang terlihat. Panduan kalibrasi
Keuntungan uang. Rumus loss tidak memuat harga masuk, besaran posisi, biaya, likuiditas, atau keputusan keluar. Skor prakiraan yang lebih rendah tidak membuktikan strategi yang menguntungkan. Evaluasi prakiraan dan transaksi membutuhkan catatan berbeda.
Kualitas universal. Skor bermakna relatif terhadap aturan, kumpulan kejadian, dan baseline. Tiga contoh fiktif ini tidak membuktikan ketepatan suatu platform di semua pasar.
Probabilitas implisit dari odds dan nilai harapan adalah pertanyaan lain. Saat membaca skor, simpan probabilitas dan hasil bersama-sama, nyatakan aturan hitungnya, lalu bandingkan yang sepadan.
Sumber dan tanggal pemeriksaan
Pemeriksaan sumber yang tercatat pada bahan rujukan sebelumnya bertanggal . Bagian relevan dokumentasi resmi untuk tulisan ini diperiksa lagi pada . Tanggal pemeriksaan bukan tanggal publikasi atau pembaruan sumber.
- scikit-learn: Brier score loss: definisi biner dan jumlah kelas, skala serta agregasi.
- scikit-learn: Log loss: basis natural, rata-rata atau jumlah, dan clipping menurut tipe data.
- scoringrules: Teori proper scoring rules: propriety dalam ekspektasi dan scoring kategorikal.
- scikit-learn: Probability calibration: kurva kalibrasi dan batas aggregate loss sebagai ukuran kalibrasi.
Halaman scikit-learn yang dibaca menampilkan versi 1.9.1. Itu nomor versi dokumentasi, bukan tanggal terbit tulisan ini atau bukti bahwa kode pustakanya telah dijalankan. Semua tabel dan kurva di atas merupakan contoh matematis, bukan probabilitas terkini atau rekomendasi transaksi.
Bagikan panduan